Нейроинтерфейс впервые объединил распознавание речи и жестов
Нейроинтерфейс научился одновременно расшифровывать речь и жесты: почему это важнее очередного рекорда точности
Исследователи Калифорнийского университета в Сан-Франциско показали, что один имплант на поверхности мозга способен одновременно распознавать попытки произнести слова и выполнить жесты у людей с тяжёлым параличом. Работа, опубликованная 14 сентября 2026 года в Nature Neuroscience, меняет саму логику развития нейроинтерфейсов: вместо отдельных систем для речи или движения появляется возможность создать единый канал управления несколькими формами коммуникации. Пока это экспериментальная технология: исследование включало всего трёх участников, одновременную работу речи и жестов в реальном времени проверяли у двух, а словарь и набор движений оставались ограниченными.
Человеческое общение оказалось сложнее задачи «прочитать речь из мозга»
Последние годы исследования интерфейсов «мозг — компьютер» быстро продвигались в нескольких направлениях. Одни системы учились восстанавливать речь, другие — управлять курсором, роботизированной рукой или другими устройствами по сигналам мозга.
Но в обычной жизни человек редко использует только один канал общения. Мы говорим и одновременно киваем, пожимаем плечами, двигаем руками, меняем выражение лица. Жест может дополнять слова, усиливать их смысл или вообще заменять короткий ответ.
Для человека с тяжёлым параличом потеря этих возможностей означает не просто невозможность произнести предложение. Общение становится гораздо менее выразительным.
Именно эту проблему решила исследовательская группа под руководством нейрохирурга Эдварда Чанга из Калифорнийского университета в Сан-Франциско. Саманта Брослер, Джесси Лю, Александр Силва и их коллеги проверили, можно ли использовать один нейроимплант для параллельного распознавания нескольких намерений человека — в данном случае речи и движений верхней части тела.
Результат оказался положительным, но одновременно обнаружил важную особенность работы мозга: просто объединить два уже существующих декодера недостаточно.
253 электрода слушали не отдельные нейроны, а активность участков коры
Исследование проводилось в рамках продолжающегося клинического исследования BRAVO — программы по созданию нейроинтерфейсов для восстановления движения и речи.
В эксперименте участвовали три человека с тяжёлым параличом конечностей и нарушением способности говорить. Причины состояния различались, включая инсульт ствола мозга и боковой амиотрофический склероз.
Исследователи использовали электрокортикографию — ECoG. В отличие от систем с микроэлектродами, проникающими непосредственно в ткань мозга и регистрирующими активность отдельных нейронов или небольших их групп, ECoG считывает электрические сигналы с поверхности коры.
В данном исследовании применялась высокоплотная решётка из 253 электродов. Она была хирургически размещена под твёрдой мозговой оболочкой на поверхности левого полушария и охватывала области сенсомоторной коры, связанные как с речевой артикуляцией, так и с движениями тела.
Это принципиальная деталь.
253 электрода не означают 253 независимые «команды», каждая из которых отвечает за определённое слово или движение. Электроды регистрируют сложные пространственно-временные паттерны активности нейронных популяций. Задача алгоритма — определить, какое намерение человека соответствует конкретной комбинации этих сигналов.
Сначала исследователи проверили, можно ли по одному импланту различать попытки движений разных частей тела — рук, лица и структур, участвующих в речи. Затем система получила два работающих параллельно декодера: один распознавал речь, другой — жесты.
Мозг не раскладывает речь и движения по независимым каналам
Здесь исследователи столкнулись с центральной проблемой работы.
Можно было предположить, что если алгоритм хорошо распознаёт попытку говорить и отдельно хорошо распознаёт попытку двигаться, то при одновременном выполнении двух задач достаточно запустить оба алгоритма параллельно.
Оказалось, что это не так.
Представительства разных движений в сенсомоторной коре частично перекрываются. Попытка произнести слово и попытка выполнить движение рукой создают не полностью независимые картины активности.
Более того, когда человек пытается говорить и жестикулировать одновременно, нейронная картина не обязательно представляет собой простую сумму сигналов, возникающих при этих действиях по отдельности.
Поэтому модели, обученные исключительно на изолированных попытках речи или движения, хуже переносили свои навыки на ситуации, когда оба действия выполнялись одновременно.
Исследователям пришлось изменить обучение алгоритмов.
В тренировочные данные включили не только отдельные попытки говорить и двигаться, но и ситуации, когда участники пытались делать это одновременно. Дополнительно каждому декодеру показывали примеры, когда активен только другой канал: например, алгоритм распознавания жестов обучался также на попытках одной лишь речи.
Так модель училась не только определять нужный сигнал, но и понимать, когда соответствующего намерения нет.
Это уменьшало число ложных срабатываний и улучшало работу двух декодеров в параллельном режиме.
Речь и жесты превратились в движения цифрового аватара
Следующим шагом стала работа системы в реальном времени.
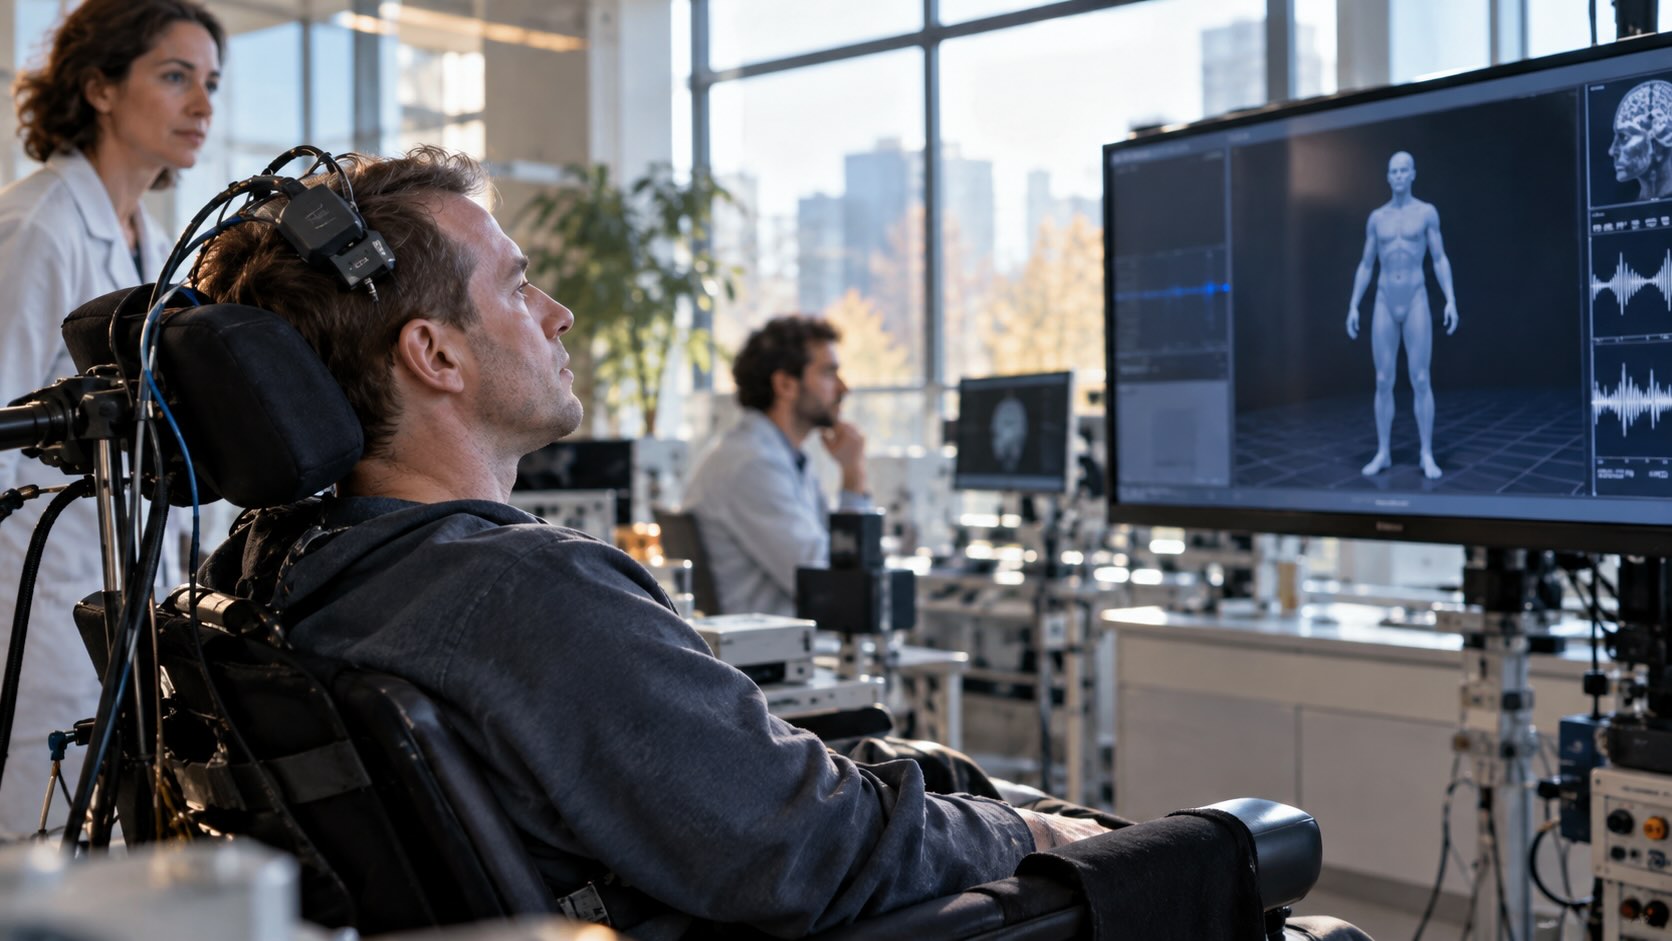
Для двух участников исследователи создали персонализированные полнофигурные цифровые аватары. Распознанная речь появлялась на экране в виде текста, а распознанные движения управляли жестами виртуального тела.
Участники могли пытаться говорить без жеста, выполнять жест без речи или делать оба действия одновременно.
В одном из разговорных экспериментов участник Bravo-6 достиг средней точности 75% для декодирования речи и 85% для жестов. Случайное угадывание в этой задаче соответствовало бы примерно 9%.
У другого участника, Bravo-1r, медианная точность в трёх блоках разговорного задания достигла 100% как для речи, так и для жестов. Однако эти показатели нельзя интерпретировать как универсальную «точность нейроинтерфейса»: участники выполняли разные задания с ограниченным набором заранее определённых речевых и двигательных вариантов, а число испытаний было небольшим.
Тем не менее система смогла в реальном времени поддерживать режим, гораздо больше похожий на естественную коммуникацию, чем традиционное последовательное управление одной функцией.
Исследователи даже продемонстрировали виртуальный разговор между аватаром участника, управляемым нейроинтерфейсом, и вторым аватаром, которым управлял экспериментатор. Речь и жесты могли использоваться отдельно или одновременно.
Главный результат — не 75%, 85% и даже не 100%
Наиболее интересный вывод работы связан не с максимальной достигнутой точностью.
Исследование показывает, что один массив электродов способен считывать достаточно информации из сенсомоторной коры, чтобы одновременно обслуживать несколько типов намерений.
Это важный переход.
Большинство нейроинтерфейсов развивалось вокруг отдельных функций: напечатать текст, синтезировать речь, переместить курсор, выбрать букву, выполнить движение. Но человеку требуется не набор независимых устройств, а система, способная работать с несколькими намерениями одновременно.
Авторы называют такой подход многоэффекторным: интерфейс должен различать сигналы, связанные с разными исполнительными системами организма — например, речевым аппаратом и верхними конечностями.
Если эта архитектура окажется масштабируемой, будущий нейроинтерфейс теоретически сможет одновременно управлять значительно большим числом функций.
Именно здесь работа выходит за пределы задачи создания более выразительного аватара.
Почему до домашнего нейроинтерфейса ещё далеко
Результат остаётся подтверждением принципиальной возможности, а не готовой медицинской технологией.
Прежде всего исследование очень небольшое. В нём участвовали три человека, а одновременное управление речью и жестами через аватар в реальном времени изучалось у двух. Этого достаточно для демонстрации технической осуществимости идеи, но недостаточно, чтобы оценить, насколько хорошо система будет работать у пациентов с различными заболеваниями, анатомией мозга и степенью сохранности движений.
Есть и проблема масштаба.
В эксперименте использовался ограниченный набор речевых ответов и жестов. Свободный разговор требует распознавания огромного пространства возможных слов, фраз, пауз, интонационных намерений и движений, возникающих непрерывно, а не только в заранее организованных испытаниях.
Авторы также отмечают необходимость уменьшать задержку системы и проверять непрерывное декодирование.
Наконец, нынешняя технология остаётся инвазивной. Электродную решётку необходимо хирургически разместить на поверхности мозга, а использованная в исследовании система соединялась с внешней электроникой через закреплённый в черепе чрескожный разъём.
Это совершенно иной уровень вмешательства, чем потребительские устройства, считывающие электрическую активность мозга с поверхности головы.
Поэтому из исследования нельзя сделать вывод, что подобные нейроинтерфейсы скоро станут массовой технологией.
Нейропротез постепенно превращается из одной функции в цифровое продолжение тела
Практическая ценность этого направления прежде всего относится к людям, которые сохранили когнитивные способности, но из-за инсульта, бокового амиотрофического склероза или других тяжёлых неврологических состояний утратили возможность нормально говорить и двигаться.
Современные вспомогательные средства позволяют некоторым из них общаться с помощью движений глаз, головы или других сохранившихся функций. Нейроинтерфейс предлагает другую идею: считывать само намерение выполнить действие ещё до того, как оно должно было превратиться в движение мышц.
Но работа группы Чанга указывает на следующий этап развития этой концепции.
Задача уже не сводится к вопросу: «Можно ли прочитать из мозга слово?» или «Можно ли по активности мозга передвинуть курсор?»
Возникает более сложный вопрос: можно ли построить универсальный интерфейс, который одновременно понимает несколько намерений человека и превращает их в согласованное поведение внешнего устройства?
Если ответ окажется положительным, цифровой аватар — лишь один из возможных вариантов применения. Та же архитектурная идея потенциально может объединять речь, мимику, жесты, управление компьютером и другими вспомогательными устройствами.
Но нынешнее исследование ещё не показывает, насколько далеко удастся масштабировать такой подход. Чем больше независимых функций потребуется декодировать одновременно, тем сложнее станет отделять перекрывающиеся нейронные сигналы и тем больше данных может потребоваться для обучения системы конкретному человеку.
- Искусственные нейроны открывают прямой канал связи с мозгом
- Motif Neurotech выводит BCI в психиатрию и меняет логику лечения депрессии
Контекст рынка и отрасли:
Реальный следующий рубеж — научить интерфейс понимать человека в свободной ситуации
Для пациентов непосредственных изменений в клинической практике эта публикация пока не создаёт. Но она меняет направление инженерной задачи.
До сих пор высокая точность отдельной функции могла восприниматься как главный показатель прогресса. Работа в Nature Neuroscience показывает, что для практического нейропротеза не менее важна устойчивость системы в ситуации, когда человек пытается делать несколько вещей одновременно.
Следующим испытанием станет не очередной рекорд в лабораторной классификации сигналов, а масштабирование.
Исследователям предстоит проверить технологию на большем числе людей, расширить словарь и набор движений, сократить задержку, перейти к более непрерывному декодированию и понять, насколько алгоритмы способны переноситься между разными ситуациями и пациентами.
Отдельный вопрос — можно ли добиться сопоставимой многофункциональности менее инвазивными способами регистрации активности мозга. Авторы прямо называют исследование других методов записи одним из направлений дальнейшей работы.
Для врачей и разработчиков вспомогательных технологий это означает постепенное изменение цели: нейроинтерфейс рассматривается уже не просто как устройство ввода информации, а как возможный протез утраченного канала взаимодействия человека с окружающим миром.
При этом эксперимент обнаружил фундаментальную инженерную проблему будущих нейропротезов: мозг не организован как набор независимых компьютерных портов. Намерения говорить и двигаться частично перекрываются в нейронной активности, поэтому систему приходится обучать именно тому сложному поведению, которое человек выполняет в реальной жизни.
Если этот принцип удастся распространить на большее число функций, нейроинтерфейсы начнут эволюционировать от устройств, выполняющих одну команду за другой, к системам, способным возвращать человеку целостное и многоканальное взаимодействие с окружающим миром.
До такой технологии ещё далеко. Но работа Nature Neuroscience показывает, каким может быть следующий этап её развития.
Для профессионального сообщества:
Данная публикация предназначена для специалистов здравоохранения и участников фармрынка. Аналитические выводы редакции носят информационный характер и не являются призывом к самолечению или заменой очной консультации врача. При работе с лекарственными препаратами необходимо руководствоваться официальной инструкцией и мнением профильного специалиста. Полный текст дисклеймера.
Источники и материалы
- Brosler S.C., Liu J.R., Silva A.B. et al. Simultaneous speech and gesture decoding for multimodal communication in paralysis. Nature Neuroscience, 2026
- Nature News. ‘Multifunctional’ brain implant translates speech and gestures in real time
- Chang Lab, University of California, San Francisco. Speech Neuroprosthesis: BRAVO Clinical Trial
- Silva A.B. et al. A bilingual speech neuroprosthesis driven by cortical articulatory representations shared between languages
- Moses D.A. et al. Neuroprosthesis for Decoding Speech in a Paralyzed Person with Anarthria. The New England Journal of Medicine